Der Motor
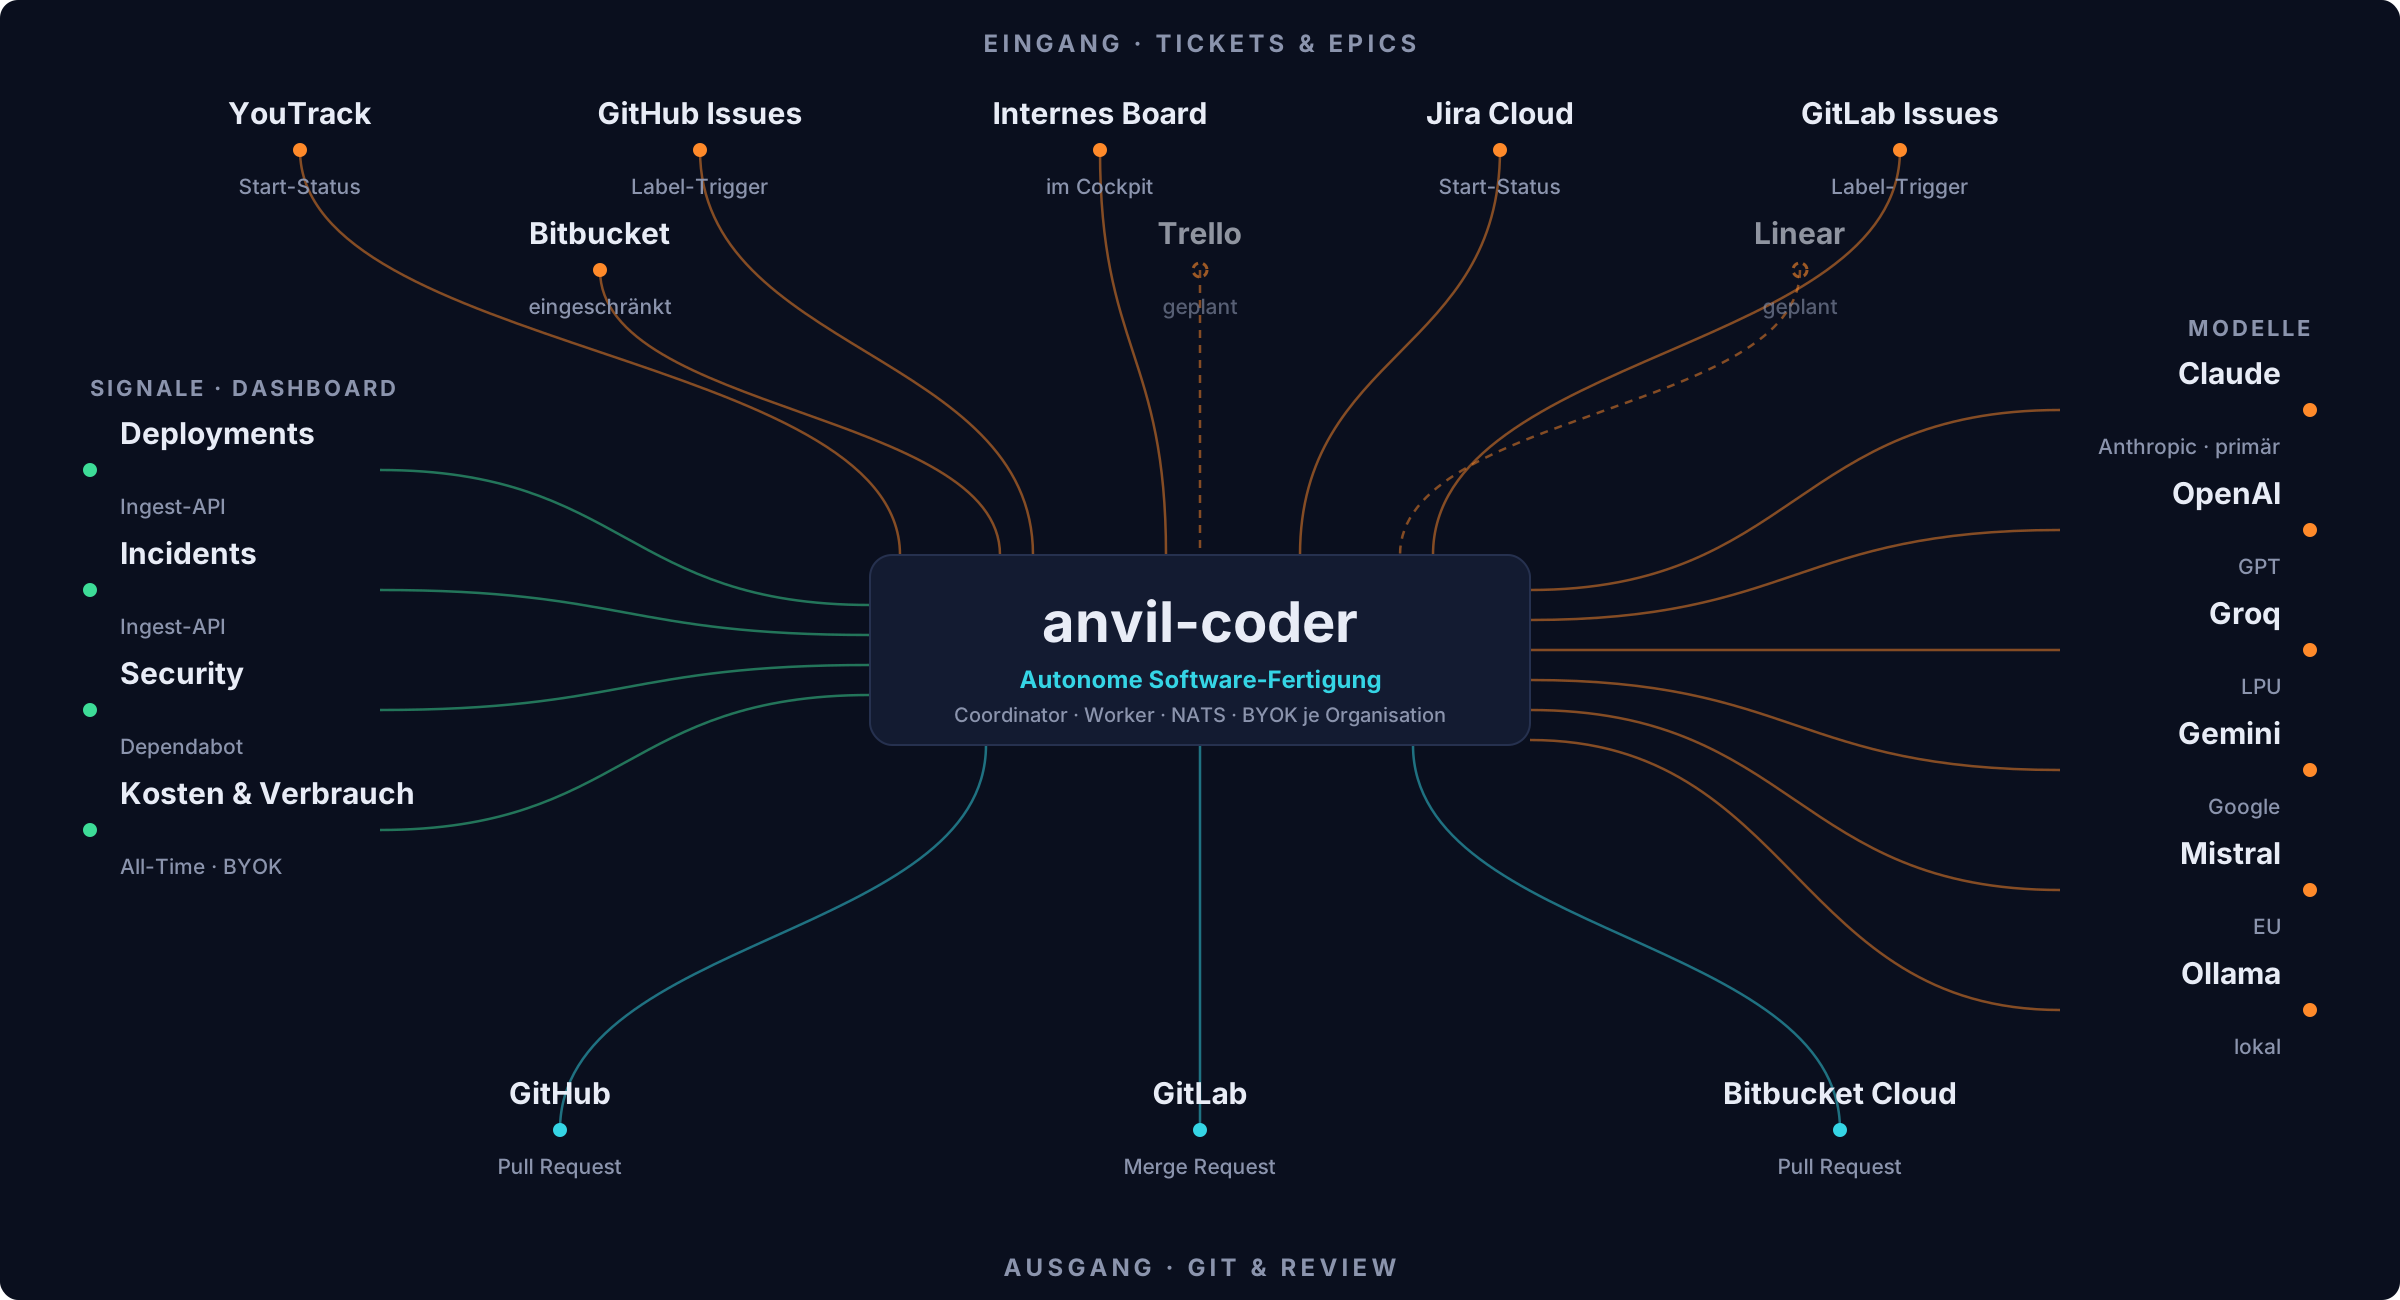
Anvil Coder plant die Umsetzung eines Tickets und verteilt sie auf kleine Arbeitsschritte. Daraus entstehen Commits und im betriebenen Dienst ein Pull-Request-Entwurf. Build und Tests sind zuschaltbar, im betriebenen Dienst eingeschaltet und benötigen eine passende Toolchain; ein nicht verifizierbares Ergebnis bleibt als solches sichtbar.
Einen Laravel-Bugfix im dokumentierten Lauf verfolgen, einschliesslich des Tests, der in seiner Sandbox nicht ausgeführt werden konnte.
Ein Sprachmodell hat ein Kontextfenster. Ein echtes Software-Projekt passt nicht hinein — nicht die Anforderungen, nicht der bestehende Code, nicht beides zugleich. Wer trotzdem ein ganzes Projekt in einen Prompt legt, bekommt eine Skizze zurück, kein Programm.
Prompt Slicing ist die Antwort darauf: die Anforderungen werden nicht zusammengefasst, sondern zerlegt. Jeder TaskSlice ist klein genug, dass er vollständig in einen Prompt passt — mitsamt dem Kontext, den genau dieser Schritt braucht.
Nicht jeder Auftrag beginnt als fertiges Ticket. Für den Text, der noch keiner ist, gibt es im Cockpit das Spec-Studio: eine geführte Spezifikation in sieben Abschnitten — vom Ziel über Rollen und Abläufe bis zum Stack-Profil —, jeder mit einem eigenen Rückfrage-Chat, der Lücken benennt statt sie zu überschreiben. Am Ende erzeugt das Studio daraus echte Tickets: Epics und Stories im gewählten Tracker, auf Wunsch samt neu angelegtem Repository.
Das Studio schreibt Tickets, keinen Code — der Lauf startet weiterhin dort, wo er immer startet: am Ticket, durch einen Menschen. Die Anleitung dazu steht in derDokumentation.
Die Ausführung läuft auf zwei Ebenen, die sich kreuzen. Phasen laufen nacheinander und sind durch Barrieren getrennt: eine Phase beginnt erst, wenn alle Arbeitsschritte der vorigen fertig sind. Am Ende steht ein Konsistenz-Durchgang über das Ganze. Misst er eine Verschlechterung, schickt er die betroffenen Arbeitsschritte in gedeckelte Reparatur-Runden. Kann er nicht messen, lässt er den Lauf wie das VERIFY-Gate durch und vermerkt am Gate einen Fehler — geprüft wurde dann nichts. Die Messung selbst steht im betriebenen Dienst bereit und wird je Projekt eingeschaltet. Ein zusätzlicher Build- und Test-Durchgang über den Gesamtstand ist zuschaltbar; im betriebenen Dienst ist er an. TaskSlices laufen innerhalb einer Phase parallel — so viele gleichzeitig, wie die Betriebsart Worker bereitstellt.
Das ist der Unterschied zwischen „schneller tippen" und „mehr gleichzeitig bauen": die Reihenfolge bleibt gewahrt, wo sie fachlich zählt, und fällt weg, wo sie nur bremst.
Ein Worker nimmt genau einen TaskSlice entgegen, führt einen AI-Prompt aus, validiert das Ergebnis und committet es. Kein Worker sieht den Gesamtplan; er sieht seinen Schritt und den Kontext, den dieser Schritt braucht. Die Koordination liegt beim Coordinator, der den Graphen hält und die Slices über eine dauerhafte Warteschlange verteilt.
Fällt ein Worker aus, geht sein Slice nicht verloren — er wird erneut zugestellt. Bleibt ein Slice unbestätigt liegen, zählt er als Bedarf und ein Worker wird nachgezogen(zuschaltbar).
Ein Lauf ist kein schwarzer Kasten. Im Cockpit lässt sich live mitverfolgen, was gerade passiert: welcher TaskSlice bearbeitet wird, welche Änderungen dabei entstehen und welche Zwischenschritte das Modell nimmt.
Dazu gehören auch die Kosten — nicht am Monatsende zusammengefasst, sondern je TaskSlice einzeln ausgewiesen: welcher Schritt wie viel verbraucht hat. Wer nachvollziehen will, wo die Zeit oder die Kosten eines Laufs hingegangen sind, findet die Antwort im Lauf selbst, nicht in einer nachträglichen Rekonstruktion.
Das Ergebnis ist kein Chatverlauf, aus dem jemand Code herauskopiert. Es ist ein Git-Repository mit Historie: jeder TaskSlice hinterlässt seinen Commit, jede Phase ihren Stand. Was dort liegt, ist prüfbar — von einem Menschen, von einer Pipeline, von einem Auditor.